Четыре разных формата.
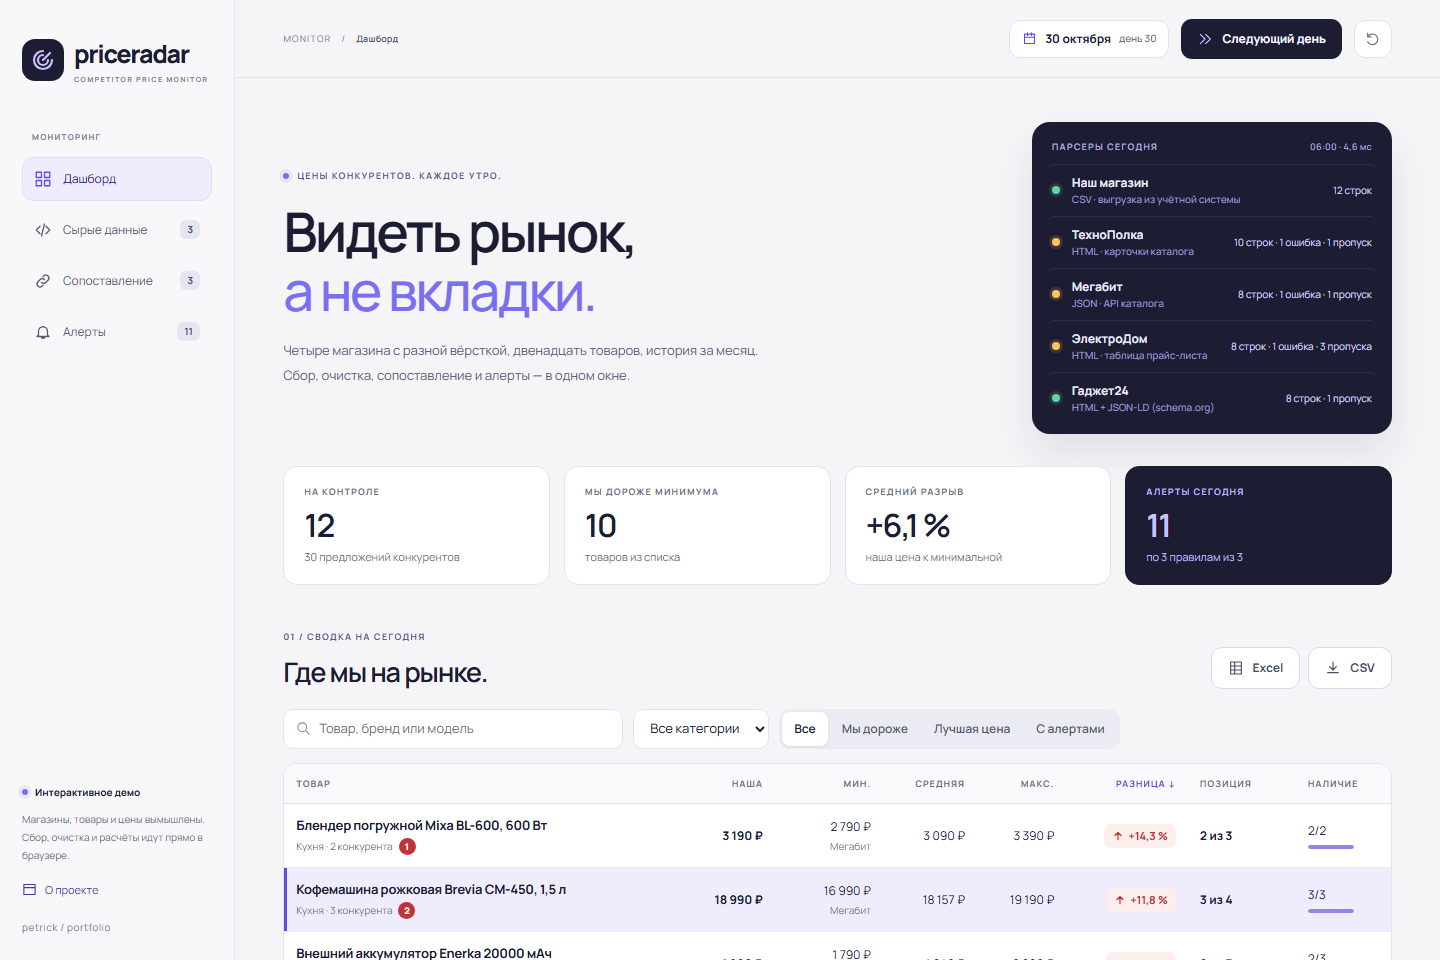
HTML-карточки, JSON API, таблица прайс-листа и данные schema.org внутри страницы. Для каждого — свой парсер и журнал: строки, ошибки, пропуски.
Мониторинг цен конкурентов: парсер нескольких магазинов, сопоставление товаров, история цен и алерты.
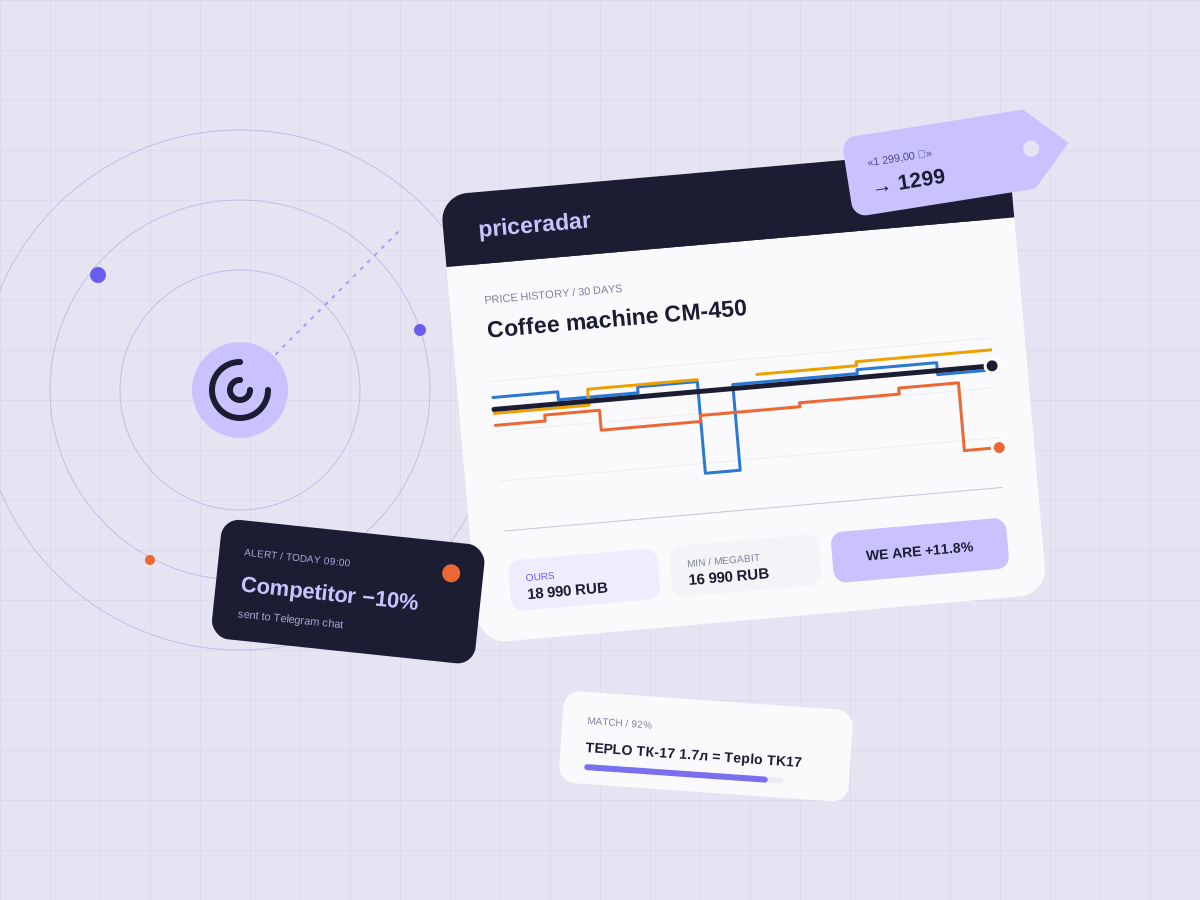
Чтобы держать цены в рынке, кто-то каждое утро открывает сайты конкурентов и сверяет цифры вручную. У каждого магазина своя вёрстка, свои названия одного и того же товара и свои способы написать цену: «1 299,00 ₽», «от 990», «нет в наличии».
PriceRadar показывает, как превратить это в одну сводку: собрать данные, очистить цены, сопоставить товары, сохранить историю и сообщать только о важном.
Это самостоятельный проект для демонстрации навыков, а не клиентский кейс. Магазины и цены в демо вымышлены. Реальные заказчики, пользователи и коммерческие результаты не заявляются.
HTML-карточки, JSON API, таблица прайс-листа и данные schema.org внутри страницы. Для каждого — свой парсер и журнал: строки, ошибки, пропуски.
Пробелы-разделители, копейки, «от», чужая валюта, «по запросу» и «нет в наличии» приводятся к числу и признаку наличия — или честно попадают в ошибки.
Нормализация названий: регистр, единицы (1500 мл = 1,5 л), кириллица-двойники в артикулах, бренды. Похожесть токенов и триграмм, спорные пары — на проверку человеку.
Конкурент дешевле на X%, товар закончился, цена изменилась больше чем на Y%. Сводка для Telegram, выгрузка в Excel и CSV.
Откройте сырые ответы магазинов и поправьте цену прямо в разметке — парсер разберёт её заново, а дашборд пересчитается. Подтвердите или отвяжите спорные пары, настройте пороги алертов и нажмите «Следующий день»: цены изменятся, история и уведомления обновятся.
 ОТКРЫТЬ ИНТЕРАКТИВНОЕ ДЕМО
Этапы отделены друг от друга: парсер ничего не знает о сопоставлении, а алерты — о вёрстке магазинов. Когда магазин меняет дизайн, правится один парсер, а не весь проект.
Сопоставление прозрачно и объясняет решение: «модель TK17, бренд Teplo, объём 1.7l». Пары с другой моделью или версией Pro не склеиваются автоматически, а уходят на проверку. Для реального каталога пороги, словари брендов и синонимы настраиваются на данных заказчика — эвристики могут ошибаться, поэтому у человека всегда остаётся последнее слово.
Реальный сбор данных ведётся с уважением к правилам сайтов: robots.txt, пользовательское соглашение, умеренная частота запросов. Сайты с защитой от ботов, авторизацией или капчей оцениваются отдельно — иногда правильнее использовать официальный API, партнёрский фид или договориться о выгрузке.
Python-скрапер по расписанию (cron или планировщик на сервере): requests/httpx и BeautifulSoup, а Playwright — только там, где без браузера не обойтись. База с историей цен и сопоставлением с вашим каталогом.
Результат — в Google Sheets или Excel, утренняя сводка и срочные алерты — в Telegram. Плюс инструкция: как добавить магазин, товар или правило.
Посмотреть, как это выглядитСписок магазинов и товаров, частоту сбора, формат отчёта и правила алертов. Каждый источник проверяется отдельно: где-то достаточно HTML, где-то есть открытый API, а защищённые площадки оцениваются отдельно. Сроки и стоимость называются после проверки источников.
Это описание состава работ для будущего проекта, а не отчёт о выполненном заказе.
Парсеры, мониторинг, отчёты в Google Sheets и Telegram-боты для ежедневной работы.
Обсудить задачу в Telegram